
La qualité de l'IA dépend entièrement de la qualité des données sur lesquelles elle repose.
La qualité de l'IA dépend entièrement de la qualité des données sur lesquelles elle repose.

Chaque semaine, un nouvel outil d’IA promet de transformer les opérations : prévoir les pannes avant qu’elles ne surviennent, optimiser automatiquement la consommation d’énergie, réduire les coûts de maintenance et minimiser les temps d’arrêt… La plupart de ces outils sont réellement efficaces. La question est la suivante : quelles données leur sont fournies ?
Selon une étude Equans réalisée en collaboration avec L’Usine Nouvelle / L’Usine Digitale, 91 % des personnes interrogées déclarent disposer de règles de gouvernance des données, mais seules 45 % d’entre elles affirment exploiter plus de la moitié des données qu’elles collectent. Pour les entreprises qui investissent dans l’IA, ce chiffre mérite réflexion, car la fiabilité d’un modèle d’IA dépend fortement de la qualité des données opérationnelles sur lesquelles il repose ; or, pour la plupart des entreprises, ces données sont soit cloisonnées, soit non structurées, soit tout simplement jamais collectées sous une forme exploitable.
Points clés à retenir
- La plupart des organisations collectent bien plus de données opérationnelles qu'elles n'en utilisent réellement : seules 45 % d'entre elles exploitent plus de la moitié des données qu'elles collectent.
- La fiabilité des modèles d'IA dépend entièrement de la qualité des données qui les alimentent : des données d'entrée incomplètes produisent des résultats qui semblent corrects, mais qui ne le sont pas.
- Dans la plupart des programmes, l'étape la plus importante n'est pas le modèle en soi, mais la mise en relation et l'organisation de ce qui existe déjà.
- Equans Digital part de la réalité opérationnelle : les équipements, les systèmes et les sources de données.
Le problème des données dont personne ne parle
Les données existent. Les données exploitables sont plus rares.
Les bâtiments, les sites industriels et les infrastructures génèrent 24 heures sur 24 d’énormes volumes de données opérationnelles : relevés de capteurs, états des équipements, flux d’énergie, paramètres de processus. Mais le problème est que la plupart de ces données n’atteignent jamais un système capable d’agir en conséquence.
Les systèmes OT (le matériel et les logiciels contrôlant les processus physiques) ont été conçus pour la fiabilité, pas pour la connectivité. Un système SCADA gérant une chaîne de production, un système de gestion technique du bâtiment (BMS) régulant le système CVC d’un hôpital, un historien enregistrant une décennie de comportement des équipements : tous produisent des données en continu. Pourtant, une grande partie de ces données opérationnelles peut rester déconnectée des environnements d’analyse qui pourraient les transformer en informations utiles.
Il en résulte une organisation qui a investi dans des capacités d’IA et qui ne comprend pas pourquoi celles-ci ne donnent pas les résultats escomptés. Dans de nombreux programmes d’IA, le modèle lui-même ne représente qu’une partie du défi. La qualité, la structure et l’accessibilité des données d’entrée importent tout autant.
Lorsque les données sont erronées, le modèle semble correct
Un modèle d’IA entraîné sur des données incomplètes ou mal structurées ne tombe pas en panne. Il produit des résultats qui semblent plausibles (prédictions, recommandations, alertes d’anomalies) mais qui reposent sur des fondements qui ne tiennent pas la route. Dans les environnements opérationnels, cela a plus d’importance que dans la plupart des autres cas. En matière de maintenance prédictive, des données incomplètes ou peu fiables peuvent réduire la capacité du modèle à détecter les défaillances à un stade précoce, limitant ainsi la valeur opérationnelle qu’il peut apporter. Un algorithme d’optimisation énergétique fonctionnant à partir de données partielles peut ancrer l’inefficacité au lieu de la réduire.
Des données de mauvaise qualité ne produisent pas d’erreurs visibles, elles conduisent à des décisions fondées sur une fausse confiance.
Ce qu'exigent réellement des données de qualité
Des données opérationnelles aux informations exploitables : les quatre étapes
La connexion avant l'intelligence
La première étape n'a rien à voir avec l'IA. Il s'agit de connecter les systèmes qui génèrent des données opérationnelles (capteurs, systèmes de contrôle, historiens, BMS) à un environnement où ces données peuvent être structurées, gérées et exploitées.
Pour de nombreuses organisations, cela implique de combler le fossé qui sépare depuis longtemps l’OT et l’IT : deux environnements qui ont traditionnellement fonctionné en parallèle et qui ne sont pas toujours connectés de manière transparente.
La structure avant l’analyse
Les données brutes issues des systèmes opérationnels ne sont pas prêtes à être analysées telles quelles. Les relevés des capteurs sont transmis dans divers formats, proviennent de différents fabricants, utilisent des protocoles incompatibles, suivent des conventions de nommage incohérentes et présentent une qualité variable. La structuration, la normalisation et la gouvernance de ces données sont rarement mises en avant lors des démonstrations de produits d’IA, alors que c’est précisément là que réside le retour sur investissement.
L’historique avant la prédiction
Les modèles prédictifs nécessitent des données historiques : un algorithme d’apprentissage automatique capable d’anticiper les pannes d’équipement s’appuie sur des milliers de cycles de fonctionnement, d’anomalies et d’interventions de maintenance enregistrées au fil des mois et des années. De nombreuses installations disposent déjà de données historiques précieuses dans leurs historiens et les journaux de leurs systèmes de contrôle. Le défi consiste à rendre ces données accessibles, structurées et connectées aux systèmes capables de les analyser.
Qu'est-ce qu'un système d'archivage des données ?
Une base de données spécialisée qui enregistre, avec horodatage, des mesures opérationnelles à haute fréquence et sur de longues périodes : températures, pressions, états des machines et flux d'énergie. Pour les programmes d'IA, les données opérationnelles historiques peuvent constituer une source d'informations particulièrement précieuse, surtout lorsqu'elles sont structurées et mises en relation avec d'autres données disponibles.
Qu'est-ce qui change lorsque les données sont correctes
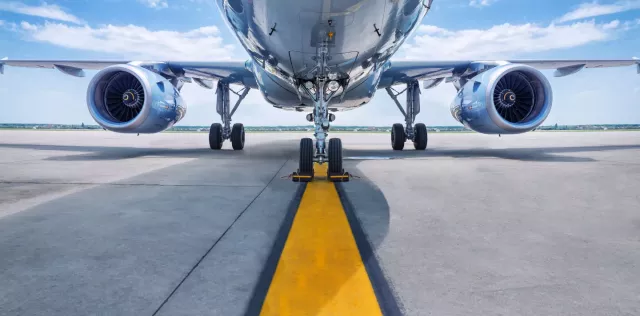
Safran, leader mondial des systèmes d'atterrissage et de freinage, a déployé 40 capteurs IoT sur des équipements de production critiques afin de collecter en continu des données de vibrations transmises à une plateforme d'analyse prédictive. Intégrées à une plateforme Industrie 4.0, ces données alimentent des alertes prédictives qui détectent les anomalies avant qu'elles ne provoquent une panne, ce qui permet de réduire les temps d'arrêt imprévus et d'optimiser les coûts de maintenance.
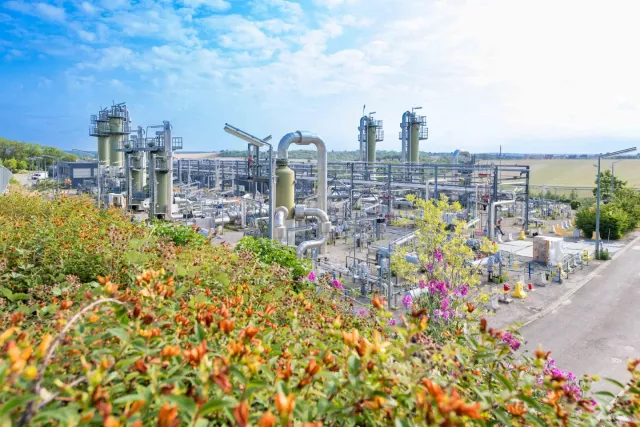
Storengy, l'un des principaux opérateurs de stockage de gaz, avait besoin de centraliser et d'améliorer la fiabilité des données techniques sur l'ensemble de ses 14 sites de stockage. Equans Digital a déployé un environnement de données commun et, en collaboration avec SAMP, un jumeau numérique en 3D afin de regrouper ces informations dans un environnement unique et structuré, améliorant ainsi l'accessibilité des données et la visibilité opérationnelle.
Ces deux projets ont commencé par relier et structurer des données techniques, puis ont développé des outils d'analyse à partir de cette base.
Partir de là où se trouvent les données
La plupart des programmes liés aux données et à l’IA sont conçus sous l’angle informatique : on définit l’architecture, on choisit la plateforme, on délimite la portée des modèles… Jusqu’à ce que quelqu’un se demande d’où viendront les données.
Equans Digital part de la réalité opérationnelle. Le point de départ est toujours la source : les équipements, les systèmes, les contraintes du terrain. Les équipes d’Equans Digital sont souvent déjà sur place, assurant la maintenance du système de gestion technique du bâtiment (GTB), gérant l’infrastructure et exploitant l’installation, avant même le lancement de tout programme de données. C’est cette proximité qui permet de connecter, structurer et orchestrer les données opérationnelles d’une manière qu’un simple fournisseur de technologies ne peut égaler : il ne s’agit pas seulement de construire la couche d’analyse, mais aussi de rendre fiable la couche sous-jacente.
“ Chez Equans, nous disposons d’un atout majeur : le fait d’avoir acquis, souvent au fil de nombreuses années, une connaissance approfondie de nos secteurs d’activité, de nos clients et de leurs installations. Souvent, nous sommes déjà présents sur place, aux côtés de notre client, dans le cadre de contrats de services récurrents. ”
Prêt à réduire l'écart entre ce que vous collectez et ce que vous utilisez ?